Un site WordPress publié n’est pas automatiquement visible sur Google. Entre la mise en ligne et l’apparition dans les résultats de recherche, il y a une étape technique que beaucoup de propriétaires de site découvrent trop tard : l’indexation. Après un audit SEO WordPress, c’est l’un des points que je vérifie systématiquement en premier, avant même de regarder le contenu.
Crawl et indexation : la distinction à comprendre avant tout
Ces deux mots sont souvent confondus, pourtant ils décrivent deux étapes différentes.
Le crawl (ou exploration) est la visite : un robot de Google (Googlebot) parcourt votre site en suivant les liens, découvre vos pages et lit leur contenu. L’indexation est la décision qui suit : Google évalue si cette page mérite d’entrer dans son index, la base de données interrogée à chaque recherche. Une page peut être crawlée sans être indexée, c’est même fréquent, si Google juge son contenu trop faible, trop proche d’une autre page déjà indexée, ou pas assez pertinent.
Cette distinction compte parce qu’elle change le diagnostic. Un site jamais visité par Googlebot a un problème d’accessibilité (robots.txt, erreur serveur, site trop récent). Un site visité mais dont les pages restent hors de l’index a un problème de qualité perçue ou de configuration, pas d’accès.
Indexer son site WordPress : la méthode complète
Cinq étapes couvrent l’essentiel pour faire indexer un site WordPress neuf ou qui n’apparaît pas encore sur Google.
- Décocher l’option qui bloque l’indexation. Dans Réglages > Lecture, la case « Décourager les moteurs de recherche d’indexer ce site » doit être décochée. Elle est souvent activée par défaut pendant la phase de développement, et oubliée au moment de la mise en ligne.
- Créer un compte Google Search Console et valider la propriété du site, par balise HTML ou par DNS. C’est l’outil officiel pour suivre et influencer l’indexation, pas une option secondaire.
- Générer un sitemap XML. Un plugin SEO (Rank Math, Yoast, SEOPress) le fait automatiquement, sans configuration technique. Le sitemap liste toutes vos URLs et aide Google à les découvrir plus efficacement qu’en suivant uniquement les liens internes. J’ai détaillé sa configuration complète dans mon article sur le sitemap XML WordPress.
- Soumettre le sitemap dans Search Console, section Sitemaps, en collant son URL complète (généralement sitemap_index.xml ou sitemap.xml selon le plugin).
- Demander l’indexation manuelle des pages prioritaires via l’outil Inspection d’URL, détaillé dans la section suivante.
Un point souvent mal compris : soumettre un sitemap n’accélère pas le classement, seulement la découverte. Ce n’est pas un raccourci vers de meilleures positions, c’est un raccourci vers la visibilité dans l’index, la condition minimale pour espérer être classé.
Indexer une page précise rapidement
Attendre le passage naturel de Googlebot fonctionne, mais pas toujours au rythme voulu, en particulier pour une page prioritaire (nouvelle page de service, article stratégique, correction urgente). Trois leviers pour accélérer cette indexation ciblée.
L’outil Inspection d’URL dans Search Console. Collez l’URL exacte de la page, laissez l’outil l’analyser, puis cliquez sur « Demander l’indexation ». Google ajoute la page à une file de crawl prioritaire, généralement traitée en quelques heures à quelques jours, sans garantie de délai précis.
IndexNow, pour Bing et Yandex. Ce protocole, porté par Microsoft et Yandex, permet de notifier instantanément ces moteurs qu’une page a été publiée ou modifiée, plutôt que d’attendre leur prochain passage. Rank Math et SEOPress l’intègrent nativement et gratuitement, Yoast le réserve à sa version premium. Google teste ce protocole mais ne l’a pas encore généralisé côté indexation classique.
La Google Indexing API. Officiellement réservée par Google aux pages d’offres d’emploi et de diffusion en direct, elle est en pratique utilisée par certains plugins (dont un module de Rank Math) pour pousser d’autres types de pages. Ça fonctionne dans les faits, mais reste une zone grise d’utilisation détournée : Google peut suspendre l’accès en cas d’usage jugé abusif. Je recommande de la réserver aux pages vraiment prioritaires, jamais en soumission automatique sur l’ensemble d’un site.
Plusieurs outils SEO payants (IndexMeNow, IndexingNow, et d’autres services similaires) proposent d’indexer vos URLs plus vite moyennant un abonnement ou des crédits. Il faut savoir ce qu’ils font réellement : ces services s’appuient eux-mêmes sur cette même Google Indexing API en coulisses, packagée dans une interface plus simple et parfois combinée avec IndexNow pour Bing. Ils n’ont accès à aucun levier que vous ne pourriez pas actionner gratuitement vous-même via un plugin comme Rank Math, ils vendent essentiellement du confort d’usage (soumission en masse, monitoring automatisé) plutôt qu’un accès privilégié à Google.
Diagnostic : les causes qui bloquent l’indexation
Un site jamais indexé après plusieurs mois a un problème identifiable, pas une malchance. Voici les causes qui reviennent le plus souvent, dans l’ordre où je les vérifie en audit.
- Une balise noindex présente sur les pages clés. Elle peut avoir été ajoutée manuellement, héritée d’un thème, ou activée par erreur dans un plugin SEO. Elle indique explicitement à Google de ne pas indexer la page, même si elle est parfaitement crawlée.
- Un fichier robots.txt qui bloque l’exploration. Une règle Disallow mal placée peut empêcher Googlebot d’accéder à des sections entières du site, parfois sans que le propriétaire s’en rende compte. J’ai détaillé les cas d’usage corrects dans mon article sur le robots.txt WordPress.
- Une page orpheline, sans aucun lien interne qui pointe vers elle. Si aucune autre page du site ne la lie, Googlebot ne peut la découvrir que via le sitemap, ce qui la rend beaucoup plus lente à explorer et moins prioritaire aux yeux de Google, qui interprète l’absence de lien interne comme un signal de faible importance.
- Un maillage interne insuffisant plus largement. Même sans être totalement orpheline, une page reliée par un seul lien profond dans l’arborescence reçoit moins de passages de crawl qu’une page bien reliée depuis des pages à forte autorité (accueil, pages piliers).
- Une balise canonical mal configurée. Si elle pointe vers une autre URL que la page elle-même, volontairement ou par erreur de plugin, Google peut indexer la version canonique désignée à la place de la page consultée, laissant cette dernière hors de l’index alors qu’elle est parfaitement accessible.
- L’absence de HTTPS. Un site encore en HTTP peut voir son exploration ralentie, Google traitant ce point comme un signal de confiance depuis plusieurs années.
- Des erreurs serveur fréquentes (erreurs 500). Elles donnent une image d’instabilité à Google, qui peut réduire la fréquence de ses visites en réponse.
- Des exclusions dans le plugin de cache. Certaines configurations de cache empêchent Googlebot d’accéder à la version à jour d’une page, ou servent une version incohérente entre deux visites.
- Un contenu jugé trop faible ou trop proche d’une page existante. Des pages générées en masse sans réel travail éditorial, ou un contenu dupliqué en interne, peuvent pousser Google à ne pas juger la page digne d’entrer dans l’index, même si elle est parfaitement accessible techniquement.
- Un site neuf sans historique. Un site qui vient d’être mis en ligne, sans backlinks ni ancienneté, peut mettre plusieurs semaines à être exploré en profondeur. C’est normal jusqu’à un certain point : un site qui existe depuis plusieurs mois et reste totalement absent de l’index a un problème plus profond que la simple nouveauté.
Le bon réflexe pour prioriser : consulter le rapport Pages de Search Console, section « Pourquoi les pages ne sont pas indexées », qui classe précisément chaque URL selon la raison de son exclusion, plutôt que de vérifier ces causes une par une sans données pour orienter la recherche.
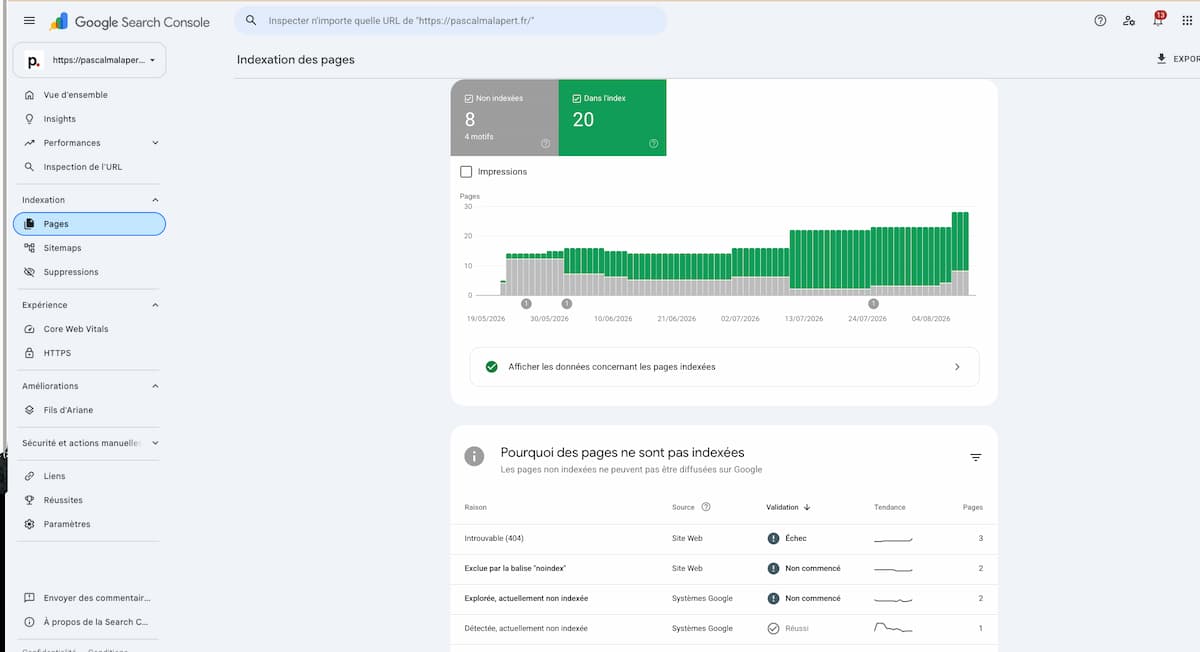
Cette liste couvre les causes les plus fréquentes que je rencontre en audit, mais elle n’est pas exhaustive. Google documente lui-même l’ensemble des statuts possibles et leur signification dans son guide officiel du rapport d’indexation des pages, utile pour creuser un cas précis qui ne correspondrait à aucune des causes listées ci-dessus.
FAQ indexation wordpress
Quelle est la différence entre bloquer une page en robots.txt et la passer en noindex ?
C’est un sujet mal compris, y compris par des propriétaires de site expérimentés : le robots.txt contrôle l’exploration, pas l’indexation. Bloquer une URL en robots.txt empêche Googlebot de la crawler, mais si cette URL est déjà connue de Google (via un lien externe ou interne), elle peut malgré tout apparaître dans les résultats de recherche, simplement sans description, avec le message « Aucune information n’est disponible pour cette page » à la place de l’extrait habituel. C’est Google lui-même qui documente ce comportement dans son guide officiel sur le robots.txt.
Pour empêcher réellement une page d’apparaître dans les résultats, la seule méthode fiable est la balise noindex, qui doit rester accessible au crawl pour que Google puisse la lire et appliquer la directive. Utiliser le robots.txt et le noindex ensemble sur la même page est contre-productif : si le robots.txt bloque le crawl, Google ne peut jamais voir la balise noindex qu’il contient, et la page reste dans la situation ambiguë décrite plus haut.
Faut-il désindexer certaines pages volontairement ?
Oui, dans plusieurs cas précis : pages de résultats de recherche interne, pages de remerciement après un formulaire, panier ou compte client sur WooCommerce, versions de test ou de staging, ou contenu dupliqué qui n’apporte rien de plus qu’une page déjà indexée. La méthode la plus fiable est la balise noindex plutôt que le robots.txt : bloquer une page en robots.txt l’empêche d’être explorée, mais si elle était déjà indexée avant ce blocage, elle peut rester visible dans les résultats sans que Google ne puisse la retirer, faute d’accès pour constater le changement.
Quelles pages WordPress sont indexées par défaut sans qu’on le sache ?
Plusieurs taxonomies génèrent des pages indexables automatiquement dès l’installation : archives de catégories, archives de tags, archives par auteur, archives par date, et pages de pièces jointes pour chaque image uploadée. Sur un site avec peu de contenu, ces pages peuvent représenter plus de volume que les vraies pages éditoriales, sans apporter de valeur propre. Les désactiver ou les passer en noindex fait partie des premiers réglages à vérifier sur une installation WordPress neuve.
L’indexation d’un site WooCommerce a-t-elle des particularités ?
Oui. Une boutique génère mécaniquement beaucoup plus d’URLs qu’un site vitrine : pages produits, pages catégories, variantes de produits, paramètres de tri et de filtre. Sans configuration, une partie de ces URLs (filtres combinés, paramètres de tri) peut être explorée et diluer inutilement le budget de crawl sur des pages à faible valeur, au détriment des vraies fiches produits.
Combien de temps faut-il pour qu’une page WordPress soit indexée ?
Il n’existe aucun délai garanti. Un site déjà établi, avec un historique de crawl régulier, peut voir une nouvelle page indexée en 24 à 72 heures après une demande manuelle via Search Console. Un site neuf, sans autorité ni historique, peut prendre plusieurs semaines, parfois plus d’un mois, avant une indexation complète. La demande d’indexation manuelle accélère le processus sans le garantir.
L’indexation Google a-t-elle un lien avec la visibilité dans les IA génératives ?
Oui, un lien direct et souvent ignoré : une page qui n’est pas indexée par Google ne peut pas apparaître dans les AI Overviews, puisque ce système s’appuie exclusivement sur le contenu déjà indexé pour générer ses réponses. L’indexation classique reste donc un prérequis, pas une alternative dépassée par l’arrivée des moteurs génératifs : sans indexation Google, il n’y a pas de visibilité IA possible via ce canal.