WordPress génère du contenu dupliqué avant même que vous ayez écrit un seul article : pages de tags, archives par date, pagination des commentaires, variantes www/non-www. Après un audit seo wordpress, c’est l’un des problèmes techniques les plus fréquents que je trouve, souvent invisible tant que personne n’a comparé les URLs indexées entre elles dans Search Console.
Qu’est-ce que le contenu dupliqué et pourquoi WordPress en génère naturellement
Le contenu dupliqué désigne des blocs de contenu identiques ou quasi identiques, accessibles depuis plusieurs URLs distinctes. Google ne sait alors plus quelle version faire autorité, ce qui dilue la valeur SEO entre les différentes URLs au lieu de la concentrer sur une seule.
WordPress en produit structurellement, indépendamment de votre contenu éditorial :
- Pages de tags et catégories : chaque étiquette créée pour un article génère une page d’archive supplémentaire qui reprend un extrait du même contenu. Un article associé à 10 tags se retrouve référencé sur 10 pages différentes.
- Archives par date et par auteur : WordPress génère automatiquement une page pour chaque mois, chaque année, chaque auteur, qui affiche les mêmes extraits d’articles que les pages de catégories.
- Pagination des commentaires : sur les articles très commentés, WordPress crée plusieurs pages pour un même article, chacune étant une variante de l’URL originale.
- Pages de pièces jointes images : par défaut, chaque image uploadée génère sa propre page dédiée avec un contenu générique quasi identique d’une image à l’autre.
- Variantes d’URL du même contenu : www vs non-www, HTTP vs HTTPS, avec ou sans slash final. Sans redirection, Google peut indexer plusieurs de ces variantes comme des pages distinctes.
Contenu dupliqué vs cannibalisation SEO : la confusion à ne pas faire
C’est la confusion la plus fréquente que je corrige en audit. Le contenu dupliqué et la cannibalisation SEO sont deux problèmes différents qui produisent un symptôme similaire (des pages qui se marchent dessus dans les résultats), mais avec des causes et des solutions opposées.
- Contenu dupliqué : plusieurs URLs affichent un contenu identique ou quasi identique. La solution consiste à indiquer à Google quelle version faire autorité, via une balise canonical, une redirection ou un noindex.
- Cannibalisation SEO : plusieurs pages ont un contenu différent, mais ciblent le même mot-clé ou la même intention de recherche. Deux articles distincts qui traitent chacun à leur façon « comment créer un site WordPress » se cannibalisent, ils n’ont pourtant aucun texte en commun.
Traiter une cannibalisation comme s’il s’agissait de contenu dupliqué mène à de mauvaises décisions : mettre une balise canonical entre deux pages au contenu réellement différent revient à sacrifier l’une des deux dans l’index, alors que la bonne solution est souvent de fusionner les deux contenus en un seul article plus complet, ou de repositionner chaque page sur une intention de recherche distincte.
Les variantes d’URL qui créent du duplicate content
Avant même de toucher aux tags ou aux archives, vérifiez que votre site n’existe pas sous plusieurs adresses aux yeux de Google. C’est souvent la cause la plus facile à corriger et pourtant la plus fréquemment oubliée.
- www vs non-www : votredomaine.fr et www.votredomaine.fr sont deux URLs distinctes pour Google, sauf si l’une redirige vers l’autre.
- HTTP vs HTTPS : si votre certificat SSL a été installé après le lancement du site, l’ancienne version HTTP peut rester accessible et indexée en parallèle de la version HTTPS.
- Avec ou sans slash final : /page/ et /page peuvent techniquement être traités comme deux URLs différentes selon la configuration du serveur.
- Paramètres d’URL : les paramètres de tracking (UTM), de tri ou de filtre sur une page catégorie ou une boutique créent des variantes de la même URL de base.
La correction passe systématiquement par une redirection 301 vers la version canonique choisie, jamais par un simple choix d’affichage dans les réglages WordPress qui laisserait les autres versions accessibles. J’ai détaillé la mise en place technique de ces redirections dans mon article sur la redirection wordpress.
La balise canonical : la solution native depuis WordPress 4.4
Depuis la version 4.4, WordPress ajoute automatiquement une balise rel= »canonical » sur chaque page, qui indique à Google l’URL à considérer comme la version de référence en cas de contenu similaire accessible ailleurs. Cette balise agit sur l’indexation, un rôle différent du robots.txt wordpress, qui lui contrôle uniquement si une page est explorée ou non, sans jamais indiquer quelle version faire autorité en cas de contenu similaire.
Sur une page produit WooCommerce accessible à la fois via son URL directe et via une URL de catégorie filtrée, par exemple, la balise canonical pointe vers l’URL directe du produit, celle que vous voulez voir indexée. C’est la solution à privilégier chaque fois que le contenu dupliqué est involontaire mais que les deux URLs doivent rester accessibles aux visiteurs, contrairement à une redirection qui supprime l’accès à l’une des deux versions.
Dans Rank Math ou Yoast, vous pouvez surcharger manuellement cette balise canonical page par page, dans le panneau SEO de l’éditeur, section Avancé. C’est utile dans les cas où le canonical automatique de WordPress ne correspond pas à votre intention, par exemple sur une page d’archive de catégorie que vous voulez faire pointer vers votre page pilier plutôt que vers elle-même.
Noindex : quand l’utiliser plutôt que le canonical
Le canonical et le noindex répondent à des situations différentes, les confondre mène à des choix contre-productifs.
- Utilisez le canonical quand le contenu dupliqué doit rester accessible aux visiteurs sous ses deux URLs, mais que vous voulez concentrer la valeur SEO sur une seule (produit accessible via plusieurs catégories, par exemple).
- Utilisez le noindex quand la page elle-même n’a aucune valeur pour un visiteur venant de Google, même si elle doit rester techniquement accessible : pages d’archives par date, pages d’archives auteur sur un site à auteur unique, pages de pièces jointes images, pages de résultats de recherche interne.
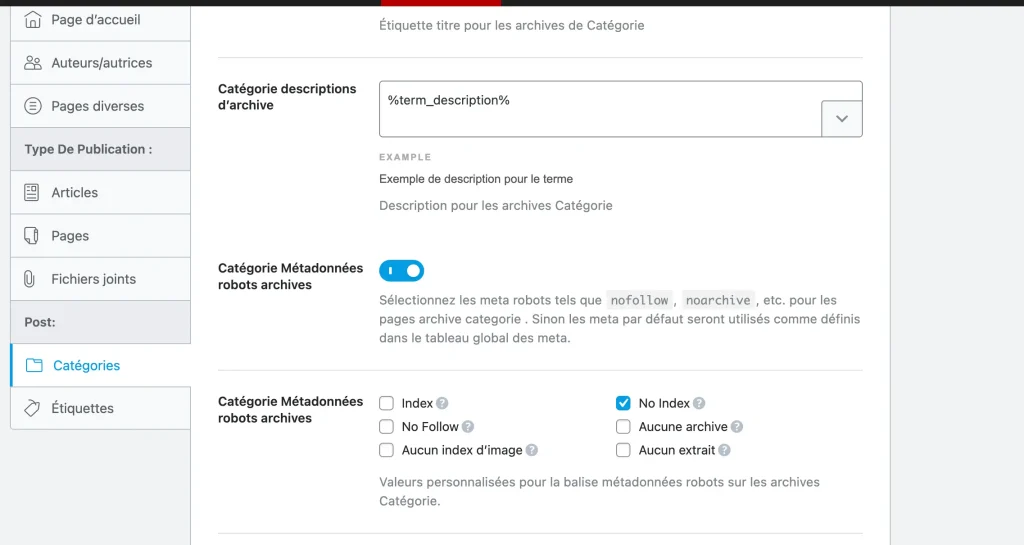
Dans Rank Math, ces réglages se trouvent dans Rank Math > Titres et Méta > Archives, où vous pouvez désactiver l’indexation des archives de date et d’auteur en un clic, sans avoir à le faire page par page. Dans Yoast, la même logique se trouve dans SEO > Apparence dans la recherche > Archives. Cette logique de tri entre ce qui mérite d’être indexé ou non rejoint plus largement les enjeux d’indexation wordpress, un sujet à part entière que je détaille séparément.
Détecter le contenu dupliqué sur WordPress
Avant de corriger quoi que ce soit, il faut savoir où se trouve réellement le problème sur votre site. Deux outils suffisent pour la majorité des cas.
Google Search Console, dans le rapport Pages (menu Indexation > Pages), signale directement les URLs exclues pour cause de contenu dupliqué, sous deux libellés à surveiller particulièrement : « Dupliquée, Google a choisi une URL canonique différente de celle de l’utilisateur » et « Dupliquée sans URL canonique sélectionnée par l’utilisateur ». Le premier cas signifie que Google a lui-même choisi une version différente de celle que vous aviez indiquée, ce qui mérite une vérification. Le second signifie qu’aucune balise canonical cohérente n’a été détectée, un signal clair d’un problème technique à corriger.
Screaming Frog, en crawlant l’intégralité du site, permet de repérer les contenus dupliqués que Search Console ne remonte pas toujours, notamment sur les pages jamais explorées par Google. L’onglet Content propose un filtre « Exact Duplicates » et « Near Duplicates » (basé sur un pourcentage de similarité configurable) qui liste les groupes de pages au contenu quasi identique, avec le pourcentage de similitude calculé entre elles.
Une fois les URLs concernées identifiées, la correction dépend de la cause : redirection 301 pour une variante d’URL involontaire, canonical pour un contenu dupliqué qui doit rester accessible, noindex pour une page sans valeur SEO propre.
Contenu dupliqué et citations IA : un angle que les audits classiques ratent
La plupart des audits SEO s’arrêtent au canonical et au noindex, en considérant le problème réglé une fois que Google sait quelle version indexer. Mais les moteurs génératifs (ChatGPT, Perplexity, Claude) ne fonctionnent pas de la même façon face au contenu dupliqué, et le traitement classique du problème ne suffit pas à garantir votre visibilité IA.
Microsoft a confirmé en décembre 2025 que les LLMs regroupent les URLs quasi identiques et sélectionnent une seule page représentative pour construire leurs réponses, les autres versions n’ayant quasiment aucune chance d’être citées. Contrairement à une dilution progressive du positionnement comme sur Google, c’est un fonctionnement binaire : soit votre page est citée, soit elle devient invisible pour ce sujet.
Autre nuance importante : la balise canonical, aussi indispensable soit-elle pour Google, ne suffit pas à garantir une citation par une IA générative. Elle indique quelle version indexer, mais elle ne donne aucune raison à un modèle de vous citer plutôt qu’une autre source traitant du même sujet avec des mots différents. Sur ce point, ChatGPT s’appuie sur l’index de Bing pour la grande majorité de ses requêtes d’agent, ce qui rend le signal de déduplication de Bing particulièrement structurant pour votre visibilité, bien au-delà de Google seul.
Concrètement, corriger votre contenu dupliqué avec canonical, redirections et noindex reste indispensable, mais ça ne crée pas de valeur différenciante aux yeux d’une IA. Une fois le ménage technique fait, la question à se poser change : qu’est-ce que cette page apporte que les autres versions ou les contenus concurrents n’apportent pas, en termes d’information réellement unique.
FAQ contenu dupliqué wordpress
Le contenu dupliqué entraîne-t-il une pénalité Google ?
Non, il n’existe pas de pénalité manuelle spécifique au contenu dupliqué involontaire. Google choisit simplement une version à indexer et ignore les autres, ce qui dilue votre visibilité sans provoquer de sanction. La pénalité manuelle existe uniquement en cas de contenu copié délibérément dans une intention manipulatoire (contenu automatisé à grande échelle, scraping).
Les pages de catégories et de tags doivent-elles être en noindex par défaut ?
Ça dépend du volume de contenu qu’elles regroupent. Une page de catégorie avec un texte descriptif propre et une sélection cohérente d’articles a sa place dans l’index. Une page de tag qui ne fait que lister des extraits identiques à ceux déjà visibles ailleurs sur le site gagne généralement à être passée en noindex, sauf si elle génère un trafic organique réel identifiable dans Search Console.
Combien de temps faut-il pour que Google prenne en compte une correction de contenu dupliqué ?
Il n’y a pas de délai garanti, mais comptez plusieurs semaines dans la majorité des cas. Google doit recrawler les URLs concernées, réévaluer les signaux canonicaux, et ajuster son index en conséquence. Soumettre les URLs corrigées via l’outil d’inspection de Search Console peut accélérer ce recrawl, sans garantir un délai précis.
Un contenu traduit dans plusieurs langues est-il considéré comme dupliqué ?
Non, à condition d’implémenter correctement les balises hreflang, qui indiquent à Google que chaque version linguistique s’adresse à une audience différente plutôt que de dupliquer le même contenu. Sans hreflang, deux versions très proches dans des langues proches (français et anglais avec beaucoup de termes techniques identiques, par exemple) peuvent effectivement être interprétées comme du contenu dupliqué.